Реклама. ООО Доверительный интервал, ИНН 7813655856. Erid: 2SDnjdEVcif
Попадание в ленту Discover может принести много трафика, но даже перспективный материал не сработает, если поисковик некорректно считает данные со страницы. В этой статье – практическая инструкция для SEO-специалистов и разработчиков, которая поможет подготовить и проверить публикацию перед выпуском.
Что такое Google Discover и чем он интересен издателям
Google Discover – лента рекомендаций со статьями и видео, которую Google формирует без поискового запроса. Пользователь открывает ленту, а система сама решает, какие материалы ему показать и в каком порядке.
Для издателей Discover – дополнительный источник трафика. Если сюжет набирает популярность, публикация может получить широкий охват, в том числе среди людей без сформированного интереса к теме.
|
Подробнее о работе рекомендательной ленты – в статье Персонализированный и неперсонализированный Google Discover: в чем разница |
Подходящей темы недостаточно, чтобы попасть в ленту. Сначала Google должен обработать содержимое страницы и определить, к какой категории относится публикация и как представить ее в рекомендациях.
Для этого система анализирует данные материала – от заголовка и изображения до разметки и технических параметров страницы. Если часть данных передается некорректно, Google может неправильно обработать публикацию, ограничить ее показы или вовсе не добавить в ленту.
|
Discover Trends помогает SEO-специалистам находить дополнительные точки роста в Google Discover. Проверяйте, есть ли трафик в нише клиента, изучайте публикации конкурентов и добавляйте в контент-план темы за пределами классического поискового спроса. Сервис помогает находить материалы с потенциалом в Discover и отслеживать, какие темы получают большие охваты. |
Какие данные Google анализирует при формировании ленты
Прежде чем подобрать публикации, Chrome или приложение Google проверяет, можно ли загрузить и обновить Discover. Система учитывает, выбран ли Google поисковой системой по умолчанию, включена ли лента и не исчерпан ли лимит ее обновлений. Он составляет около 20 запросов фида в день.
Дальше на сервер отправляется большой набор данных, среди которых:
-
Технические характеристики. Язык и локаль, размер экрана, операционная система, версия Chrome и другие настройки приложения или браузера.
-
Интересы пользователя. Google учитывает, к каким материалам пользователь переходил за последние сутки, 7, 14 и 30 дней. Более свежие интересы сильнее влияют на персонализированные рекомендации.
-
История ленты. Когда приложение запрашивает у серверов Google новую подборку для Discover, то передает данные о материалах, которые пользователь уже видел. В списке может быть до 500 публикаций – это позволяет не дублировать показ карточек.
-
Действия с карточками. Система фиксирует показы и клики, позицию материала в ленте, категорию, источник, отметки пользователя «Не показывать этот контент».
Google заранее прогнозирует вероятность клика по карточке – этот показатель называется PCTR, или прогнозный CTR. После показа система сравнивает прогноз с реальным поведением пользователя: кликнул он по материалу, пролистал карточку или скрыл ее. Эта реакция может использоваться для корректировки PCTR и влиять на дальнейшее ранжирование.
Каждая карточка сохраняется в ленте Discover до 48 часов с момента первой загрузки. После этого приложение принудительно запрашивает обновление, поэтому со временем старые рекомендации заменяются новыми.
Как Google получает данные о материале
Перед тем как представить публикацию в Discover, Google собирает данные о самой странице. Их обработка начинается на сервере. Googlebot получает HTML, извлекает структурированные данные и метатеги, а затем передает материал на классификацию. Система определяет его тематику и другие признаки, которые используются при подборе рекомендаций.
Информация берется не из одного источника – для разных параметров предусмотрены цепочки фоллбэков, то есть резервных источников. Если значение не найдено в приоритетном, Google проверяет следующий в цепочке.
Вот источники, из которых Google получает основные данные о публикации:
|
Сигнал |
Цепочка фоллбэков |
|
Title |
Schema.org → og:title → twitter:title → HTML title |
|
Image |
og:image → twitter:image → og:image:secure_url |
|
Publisher |
Schema.org → og:site_name → author (HTML) |
|
Language |
og:locale → inLanguage (JSON-LD) → "en" |
|
Paywall |
article:content_tier + isAccessibleForFree |
Один и тот же параметр, например заголовок или издатель, может быть указан сразу в нескольких источниках. Если значения различаются, Google выбирает между ними. Поэтому HTML, структурированные данные и Open Graph лучше согласовывать между собой. Далее на примере заголовков мы покажем, к чему могут привести расхождения.
Обработка страницы не заканчивается первым обходом Googlebot. После того как пользователь открывает публикацию, приложение дополнительно проверяет ее состояние и передает данные на сервер Google. В частности, система отслеживает доступность материала, изменения метаданных, а также пэйвол – ограничение доступа к контенту.
RSS и WebFeed
Кроме обычного обхода сайта Google может узнавать о новых публикациях через WebFeed – дополнительный канал, связанный с RSS-фидами издателей. Если пользователь подписывается на источник публикации, Google находит его RSS-фид и учитывает подписку при формировании рекомендаций. Материалы такого источника могут появляться в рекомендациях чаще.
Для публикаций, полученных через WebFeed, Google собирает те же данные о взаимодействиях, что и для остальных карточек Discover: показы, клики и другие действия пользователей. Поэтому реакция подписчиков потенциально может учитываться при оценке фактического CTR материала. Кроме RSS, WebFeed отдельно проверяет favicon сайта – его доступность и корректность тоже нужно включить в технический аудит.
Как Google выбирает и переписывает заголовки
У одной публикации может быть несколько вариантов заголовка: в Schema.org, Open Graph, Twitter-разметке и HTML. Но при этом не всегда в карточке Discover появляется один из заданных издателем вариантов.
Из 34 тысяч публикаций, изученных WSS, только в 32% случаев заголовок в ленте совпал и с Open Graph, и с HTML title.
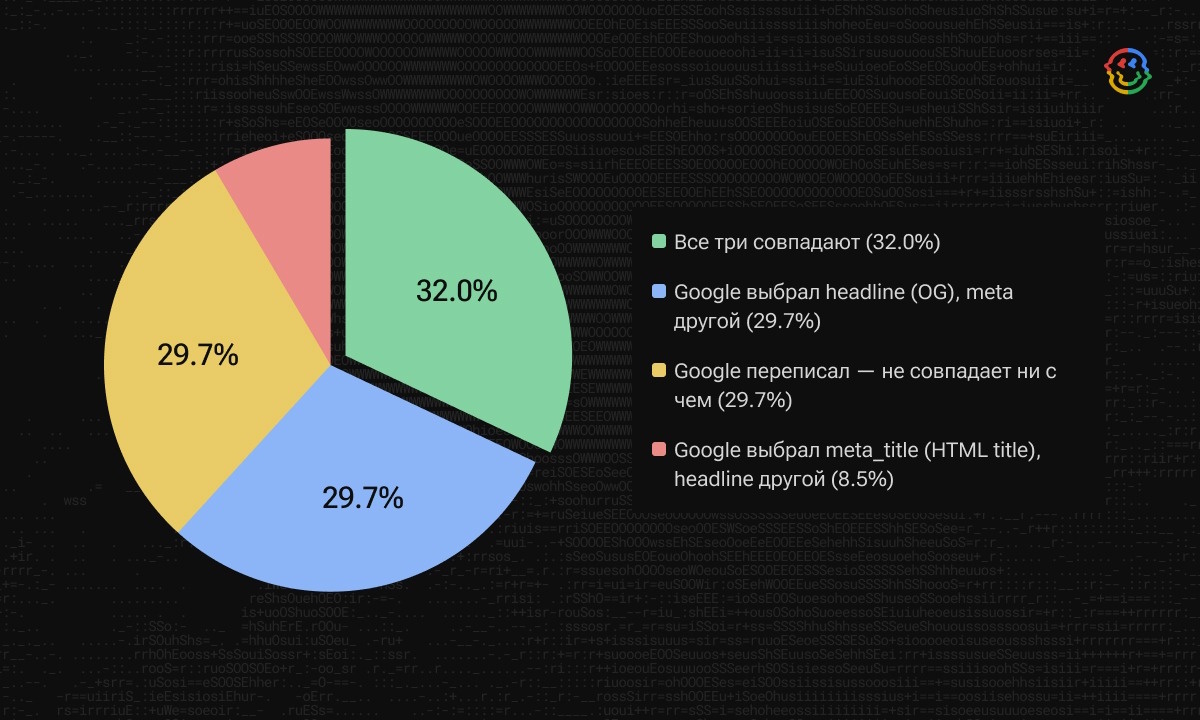
Как Google выбирает заголовки
Google может изменить один из заданных заголовков или сгенерировать новый, даже если такого варианта нет ни в одном элементе страницы.
Например, у Euronews выходила статья с заголовком «Польский мега-аэропорт станет одним из крупнейших транспортных узлов Европы». В Discover Google сформировал более конкретный вариант – «Польша строит мега-аэропорт за 30 миллиардов евро», взяв сумму из публикации.
Еще Google может убирать служебные части заголовка. Примерно в 16% показов из выборки система удаляет брендовый суффикс, например название издания, добавленное в конце: «Заголовок статьи – XBT Games». Аналогично Google может убрать и название рубрики, например «Заголовок статьи – Новости». Поэтому прописанный в title бренд или раздел не гарантирует, что пользователь увидит их в карточке Discover.
Как подготовить изображение для Google Discover
Изображение влияет на то, как материал отображается в Discover, а технические параметры файла – на возможность корректно показать карточку. К иллюстрации есть несколько требований:
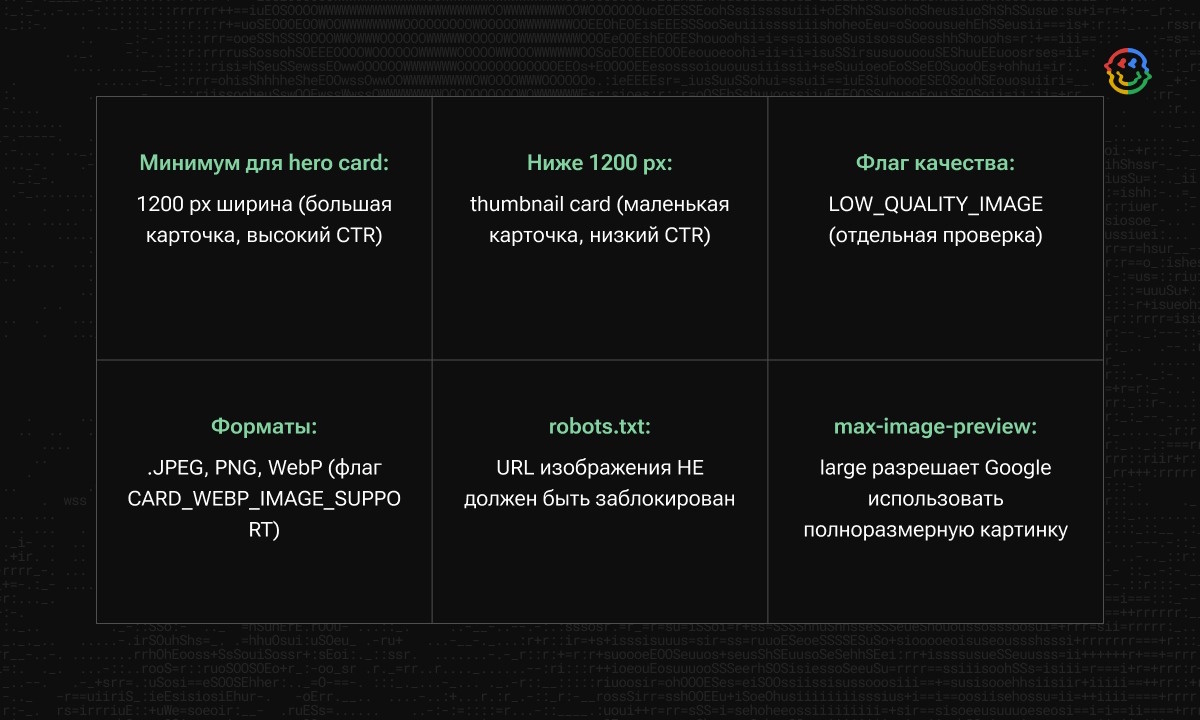
Основные требования к изображениям для карточек Google Discover
Для крупного превью используйте картинку шириной не менее 1200 пикселей. Если она меньше, материал, скорее всего, получит thumbnail – небольшое изображение рядом с заголовком.
Еще один обязательный параметр внутри метатега robots – max-image-preview: large. Он разрешает Google использовать полноразмерное изображение в результатах и рекомендациях. Без этого картинка отображается только в уменьшенном формате.
Также уточните, какое изображение указано в Open Graph – метатеге og:image. Google может получить картинку из нескольких источников, но вариант из Open Graph иногда становится приоритетнее изображения из микроразметки.
Перед публикацией проверьте и технические параметры файла:
-
Доступность файла. URL изображения должен открываться для Google и не быть заблокирован в robots.txt.
-
Качество изображения. Убедитесь, что картинка четкая, без заметного размытия, пикселизации и других дефектов.
-
Формат файла. Используйте JPEG, PNG или WebP. Данных о преимуществе какого-либо из этих форматов для ранжирования нет – все они могут нормально отображаться в ленте.
Можно ли менять заголовок и изображение после публикации
Google замечает изменения во время показов материала в Discover. После открытия статьи пользователем система повторно проверяет часть метаданных и передает новые на сервер.
Менять заголовок или картинку можно, пока материал получает показы в Discover. Но сама правка не запускает рост охватов – многое зависит от того, что именно меняется и в какой момент.
Например, на Stavka.tv материал о матче «Сочи» – «Спартак» достиг пика видимости около 16:00 UTC – примерно за полчаса до начала игры. Позднее коэффициент в заголовке обновили, но это не помогло продлить показы. К моменту смены коэффициента волна интереса прошла, так как аудитория в основном уже сделала ставки.
Предсказательная модель Google знает про паттерны, которые снижают CTR. Если их убрать, показы могут вырасти. Но смена заголовка сама по себе не дает автоматического буста – это скорее еще один способ попасть в ленту, если исходная формулировка не нравится Google.
Как проверить язык и локаль
Google учитывает язык текста и регион, для которого предназначена публикация. Для определения языка предусмотрена цепочка фолбэков:
og:locale → inLanguage в JSON-LD → язык по умолчанию.
Перед публикацией проверьте:
-
og:locale – сочетание языка и региона, например ru_RU или en_GB.
-
inLanguage в структурированных данных.
-
Соответствуют ли эти значения друг другу и реальной аудитории материала.
-
Не осталась ли в шаблоне локаль другой языковой версии сайта.
-
Не ограничивает ли указанная локаль публикацию регионом, на который материал фактически не рассчитан.
Ошибки здесь могут заметно сказаться на показах. Мы наблюдали ситуации, когда настройки локали заметно влияли на географию показов. Например, у издателей, которые сужали локаль до отдельного города, трафик из Discover резко падал. А при сочетании английского языка с локалью Португалии публикации переставали показываться в других странах, а в некоторых случаях трафик снижался почти до нуля.
Локаль лучше задавать исходя из фактического языка и географии аудитории, а не пытаться с ее помощью дополнительно сузить таргетинг.
Если публикация предназначена для нескольких рынков, проверьте настройки каждой языковой версии страницы.
Что может помешать материалу появиться в ленте Discover
До формирования готовой ленты Discover срабатывают четыре уровня фильтрации: три на стороне клиента и один на сервере. Первые три определяют, можно ли загрузить и обновить ленту, а четвертый – какие материалы попадут в нее.
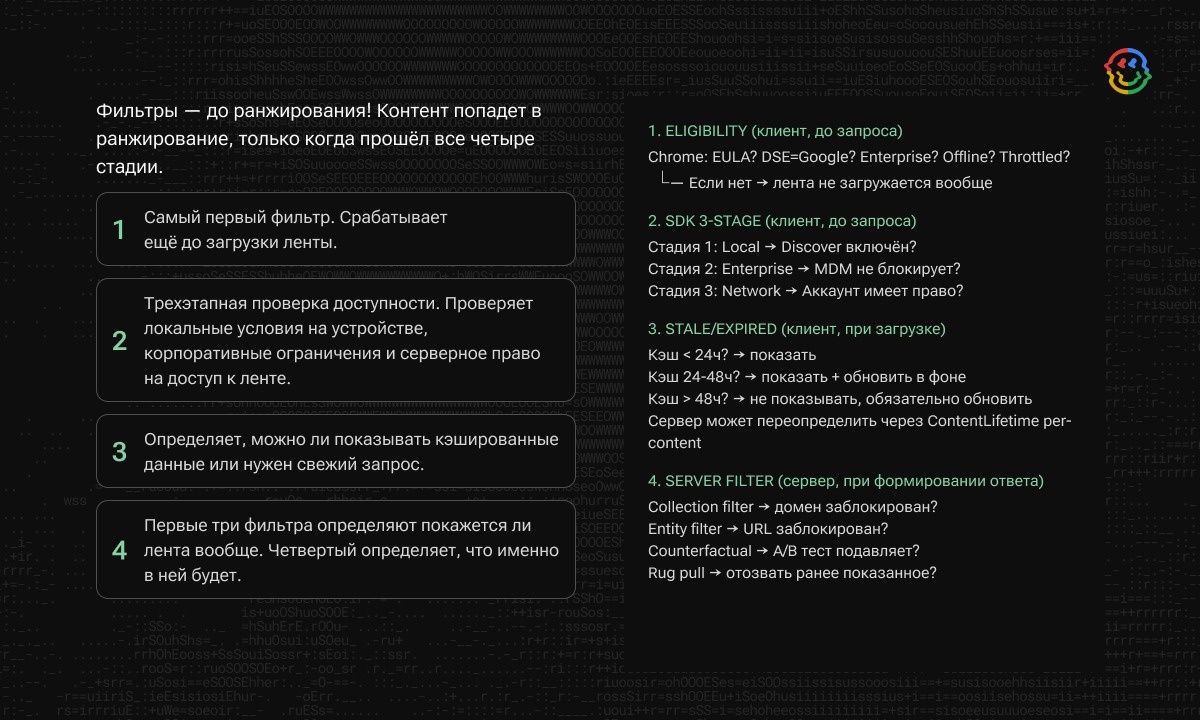
Четыре уровня фильтрации при формировании ленты Google Discover
Часть фильтров зависит от настроек устройства пользователя и внутренних механизмов Google – издатель не влияет на них. Но параметры сайта и самой публикации можно контролировать.
Вот несколько рекомендаций, которые снизят риск того, что материал отсеется на этапах фильтрации.
Проверьте разметку пэйвола. После открытия статьи Google дополнительно определяет, доступен ли материал пользователю. Для этого используются признаки article:content_tier и isAccessibleForFree. Если контент закрыт, система может исключить карточку из ранжирования. Поэтому значения в разметке должны соответствовать реальному состоянию страницы. Следите, чтобы открытый материал по ошибке не был помечен как находящийся за пэйволом.
Учитывайте фильтрацию на уровне домена. Перед окончательным формированием фида работает серверный фильтр. Если домен заблокирован, его публикации могут пройти индексацию и классификацию, но не попадут в готовую ленту. Поэтому при резком исчезновении показов проверьте URL и состояние домена в поиске.
Следите за доступностью Open Graph Image. Google повторно проверяет изображение уже после визита пользователя. Если og:image изменился, Google может заменить картинку, а если файл стал недоступен – и вовсе исключить материал из Discover. Поэтому после публикации не удаляйте исходный файл, не меняйте его URL на несуществующий и не закрывайте доступ к нему.
Технический чек-лист перед публикацией
Перед выпуском материала проверьте основные технические параметры страницы и карточки Discover:
-
Заголовки согласованы. headline в Schema.org, og:title, twitter:title и HTML title не противоречат друг другу.
-
Основное изображение указано в og:image.
-
Ширина изображения – не менее 1200 пикселей, если нужна карточка с крупным превью.
-
Указана директива max-image-preview: large.
-
Изображение доступно Google: URL действителен, файл не заблокирован в robots.txt, картинка сохраняет качество после сжатия.
-
Язык и локаль указаны корректно. og:locale и inLanguage соответствуют языку страницы и региону аудитории.
-
Пэйвол размечен правильно. article:content_tier и isAccessibleForFree соответствуют фактическому доступу к публикации.
-
RSS-фид правильно указан на странице, доступен для загрузки и содержит актуальные материалы, а favicon сайта корректно загружается.
-
Страница и ее основные элементы доступны Googlebot и не закрыты от обхода.
Эти настройки не гарантируют попадание в Discover, но снижают риск технических ошибок и помогают Google корректно обработать публикацию.
|
Техническая подготовка – важная, но не единственная часть работы с Discover. В следующем материале разбираем, как находить перспективные тренды, выбирать момент публикации и получать из ленты больше трафика |

 Теги: